- 0
- 0
- 分享
- 2026-09-18 10:24
你有没有想过:产线上的相机"啪"地拍一张图,几十毫秒之内,系统就能告诉你——传送带上这个零件是哪个、在哪、转了多少度。
很多刚入行的同学第一反应是:这不就是深度学习吗?训练个网络,端到端搞定。
做了多年工业视觉之后,我的答案恰恰相反:大量高节拍的定位工位,跑的并不是神经网络,而是一个更老、更稳、更快的东西——轮廓模板匹配。
这一篇就把它讲明白:它是什么、为什么好用、怎么工作的。不推导公式,不贴代码,保证大学生也能看懂。
一、先回答"是什么":给目标拍张"轮廓名片"
模板匹配分两步,想成"办会员卡"和"刷卡"就懂了:
第一步:建模(离线,只做一次)。
拿一张标准图,用矩形框圈住目标,算法把框内目标的边缘轮廓提取出来,做成一份模板。这份模板记住的不是目标的灰度长相,而是它的"轮廓指纹"。
第二步:匹配(在线,每一帧都做)。
后续相机拍到的图里,算法拿着这份轮廓指纹去逐个位置比对:哪个位置、哪个角度、哪个大小能对上,就输出坐标、旋转角度、缩放倍数和匹配分数。
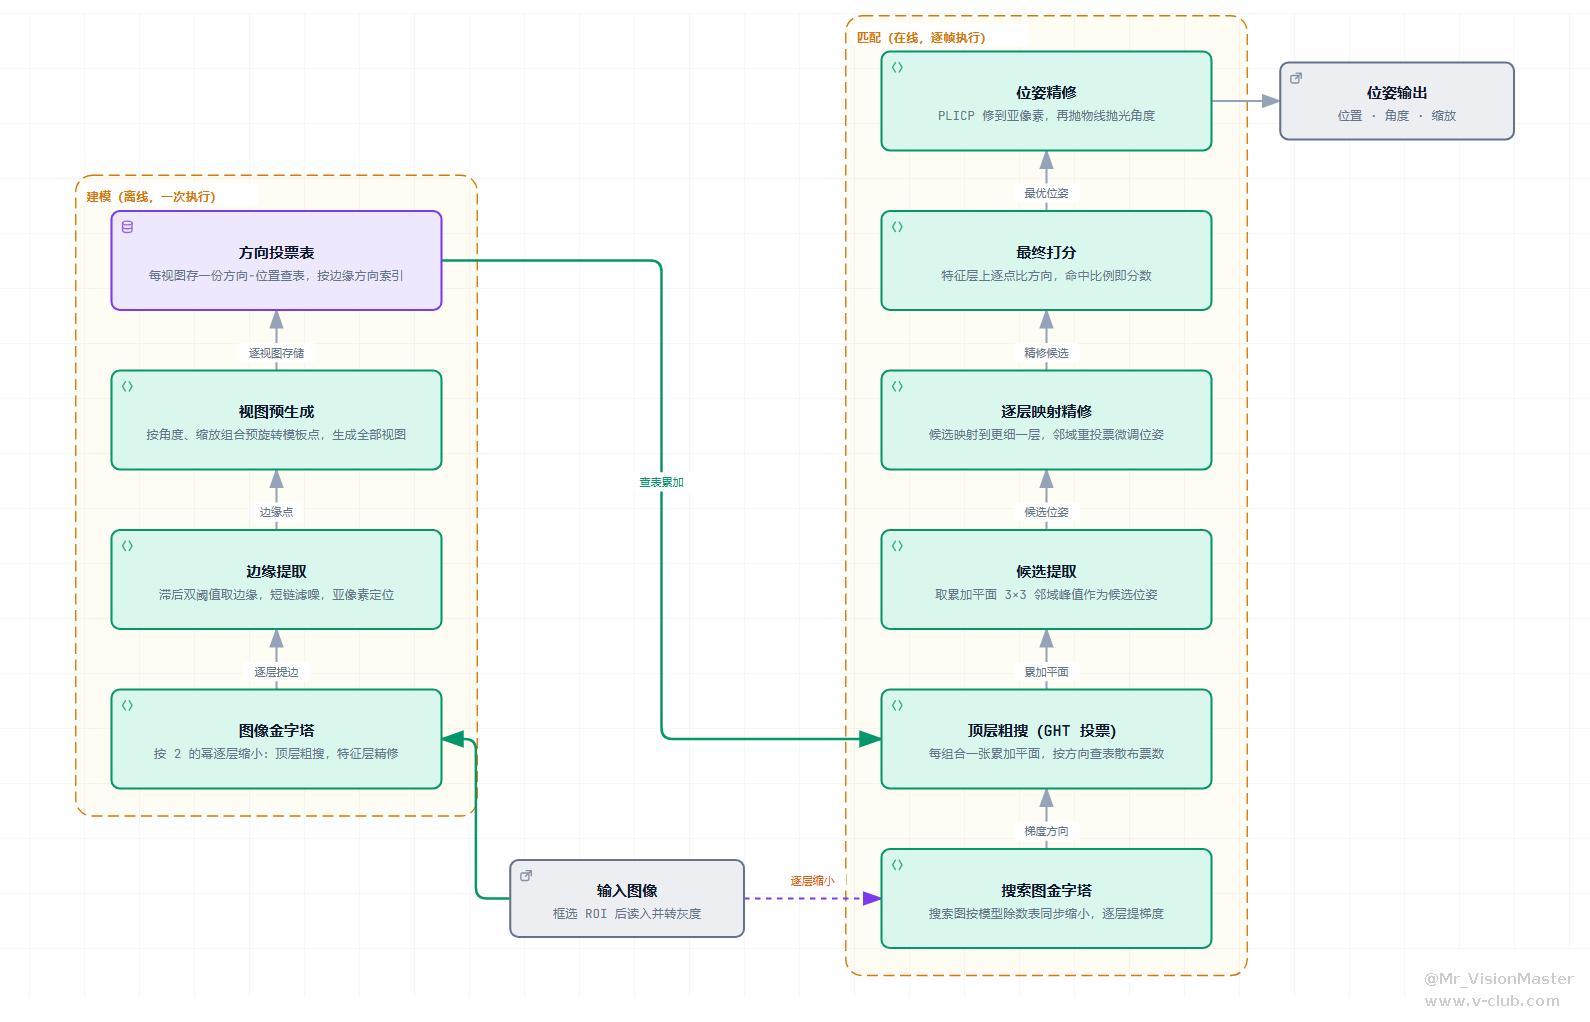
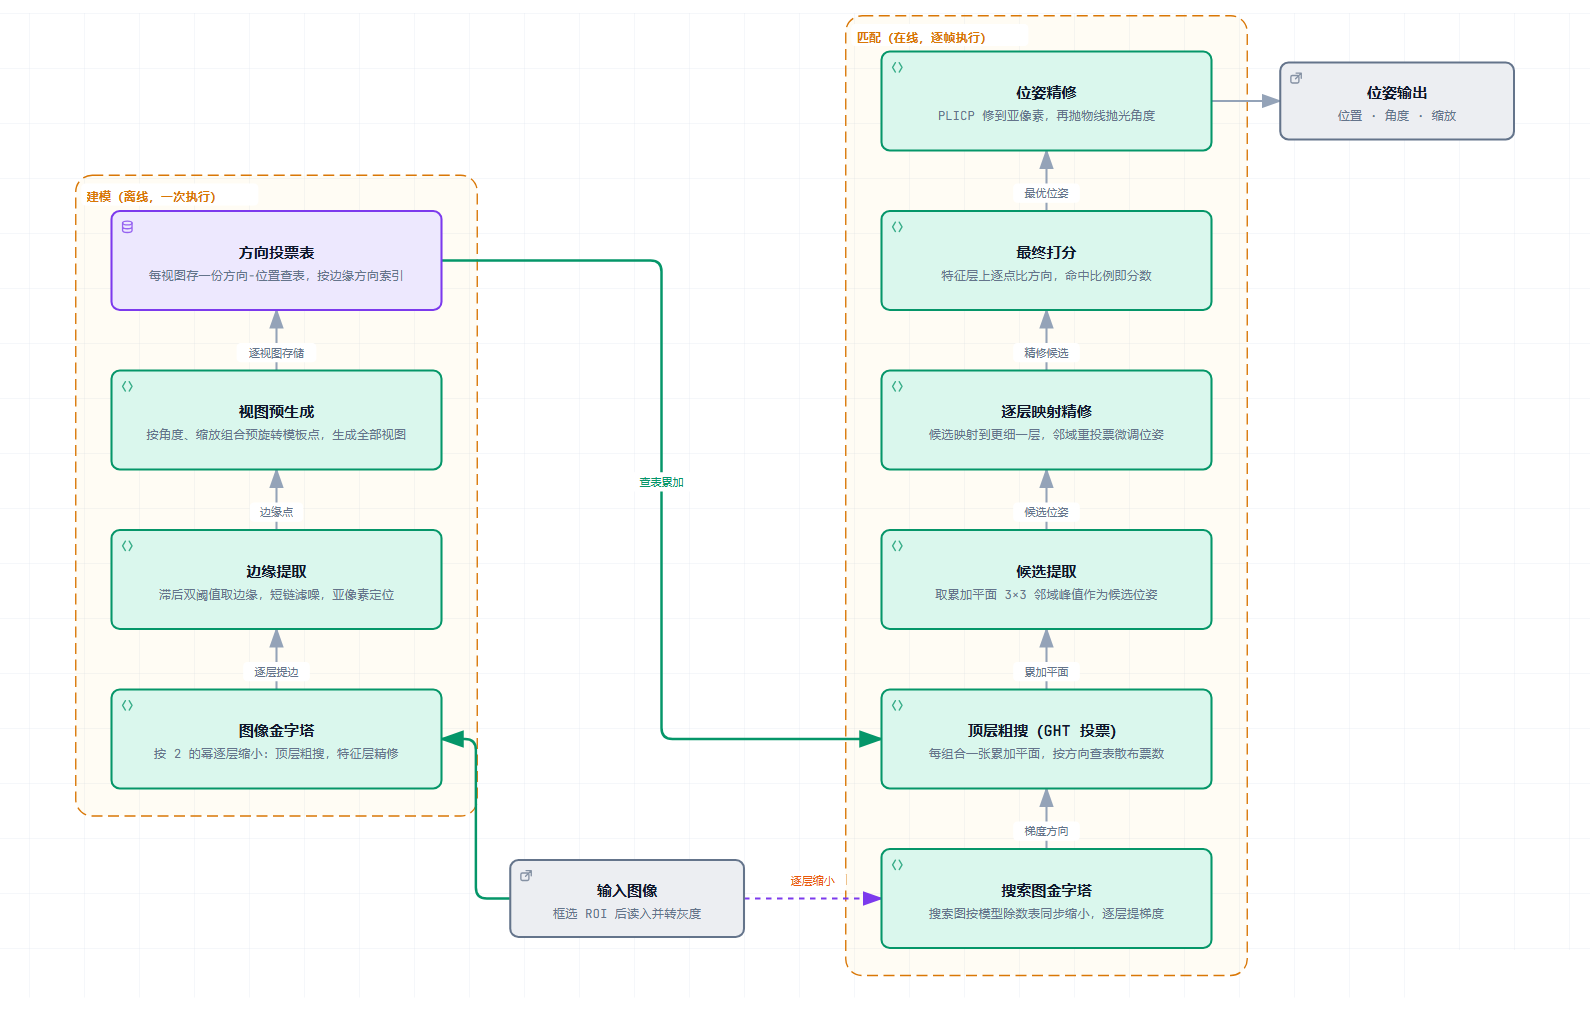
整个过程就分这两个阶段:建模阶段离线执行一次,匹配阶段在线逐帧执行。左边攒"名片",右边刷"名片"。
二、为什么只看轮廓、不看灰度
这是模板匹配最反直觉、也最关键的设计。
很多人以为,要认出一个物体,就得记住它"长什么样"——颜色、纹理、明暗。但在工厂里,这条路走不通:
- 同一个零件,早班和晚班的打光不一样;
- 金属表面反光,换个角度就变样;
- 有些工位还会遇到明暗反转(比如从白底黑字变成黑底白字)。
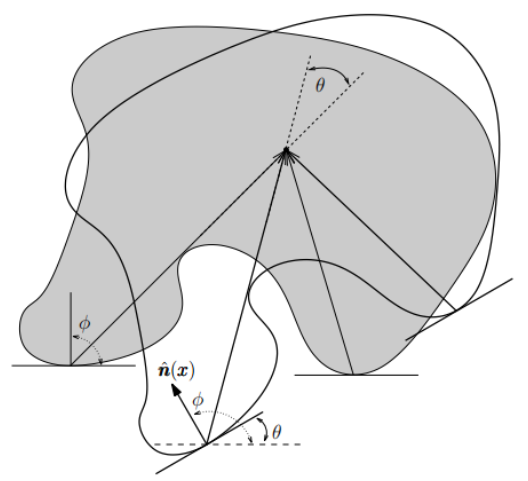
灰度是善变的,但目标的轮廓形状是刚性的——零件转 30 度,它的边缘走向关系也跟着转 30 度,不会凭空消失。
所以这类算法只提取边缘上的梯度方向:边缘从哪个方向"亮变暗"。方向关系是形状的骨架,光照怎么变,骨架基本不变。这就是为什么它敢说:亮度变化、打光不均、甚至明暗反转,都不影响定位。
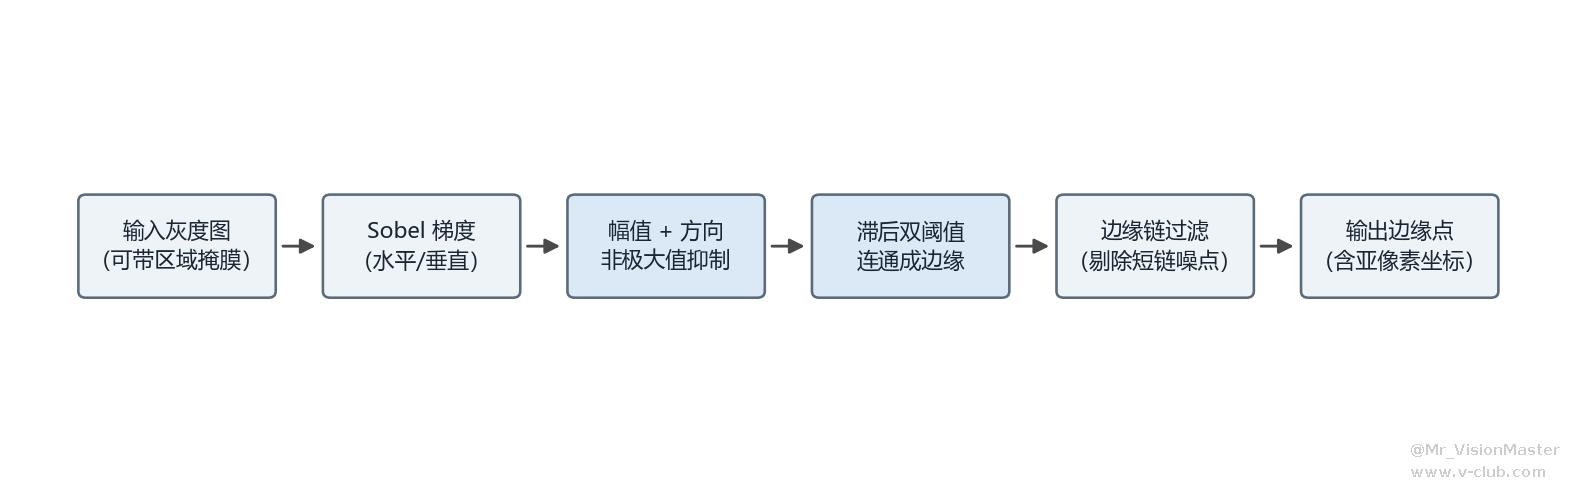
当然,只看轮廓也有代价:目标必须刚性(不能是软的、会形变的),轮廓要清晰(毛边太多谁都认不出)。这是适用边界,后面第三篇细说。
三、它是怎么"找"的:从粗到细的搜索
匹配阶段要回答三个问题:在哪(位置)、转多少(角度)、多大(缩放)。三个自由度组合起来,搜索空间是巨大的——逐个位置逐个角度去试,算到天荒地老。
工程上的解法是由粗到细,像找人一样:
- 先眯起眼睛(看缩小的模糊图),扫一眼确定"人大概在那边";
- 再走近一步,确认姿势;
- 最后凑近看细节,精确到鼻尖。
对应到算法里,就是图像金字塔:把原图逐层缩小,在最粗的层上快速圈出少量候选,再逐层往下,只在候选附近的小窗口里精细调整,最后在最细层上打分。
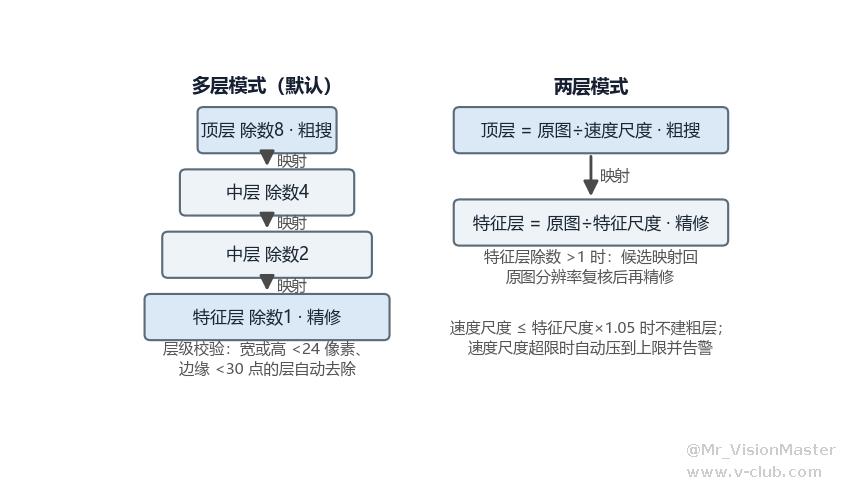
搜索范围从"整幅图 × 全角度 × 全缩放"收缩成"候选附近的巴掌大",这就是速度的来源。这一步具体怎么压缩计算量,第二篇展开。
四、找到了之后:把答案修到"亚像素级"
粗定位给出的位置是"格子级"的(比如精确到 1 个像素、1 度)。工业定位常常要求更细——亚像素、零点几度。
所以匹配的最后还有收尾精修:先做抛物线插值把答案从档位之间"内插"出来,再用点到线的迭代最近点方法(一类公开的经典算法)把模板轮廓"贴"到搜索图的边缘上,反复微调,直到收敛。
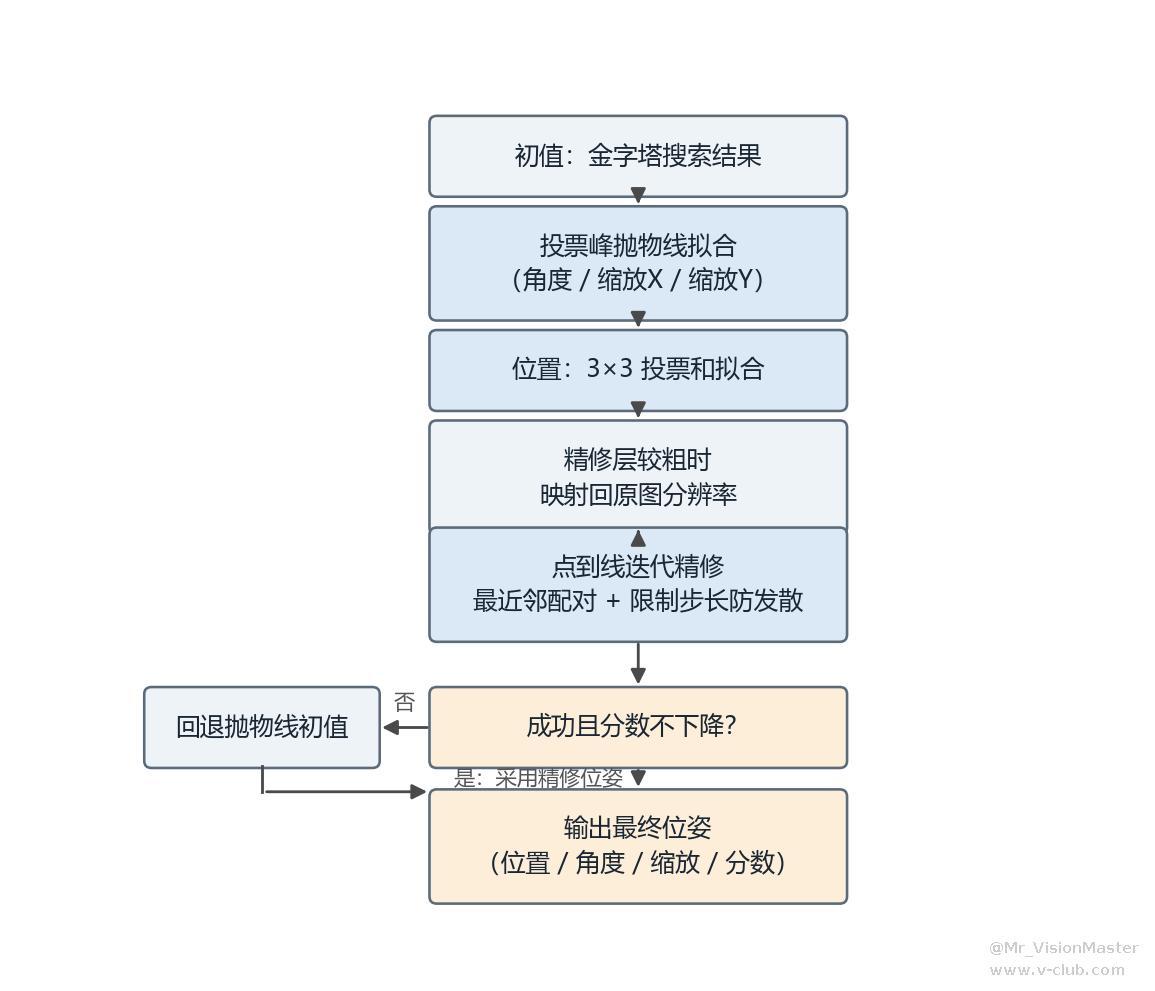
一个直观的理解:粗定位告诉你"锁孔大概在这",精修负责把钥匙稳稳插进去。
五、它能干什么活
四个最常见的场景:
- 计数:画面里十几个相同零件,数出个数、框出每一个;
- 定位:给机械臂或测量工序提供基准坐标(视觉定位是大多数检测工序的第一步);
- 缺陷检测:先精准定位,再在标准位置上做比对检查;
- 分类识别:多个相似型号里认出"这是哪一型"。
常见误区,一次说清
误区一:模板匹配 = 逐像素灰度比对。
那是教科书里的相关匹配,对光照极其敏感,工厂里基本不能用。现代轮廓匹配只看边缘梯度方向,就是为了让光照"闭嘴"。
误区二:这种问题必须上深度学习。
深度学习擅长"变着花样也认识你"的语义问题。而工业定位要的是"同一个刚性目标,毫米级重复定位"——几何方法确定性强、速度快、不需要标注数据,反而更合适。
误区三:模板匹配很慢。
做对了工程取舍,毫秒级是正常水平。怎么做到的,见第二篇。
用一句话总结这一篇:
工业视觉的第一课,往往不是神经网络,而是学会把"它是什么"和"它在哪里"拆成两个问题来回答——轮廓模板匹配,就是后者的答案。
下一篇讲工程:同样的原理,为什么有人写出 90 毫秒,有人写出 5 毫秒。


 在VisionMaster里用自定义算法模块跑YOLOv82026-08-26
 USB工业相机掉线问题排查指南2026-08-26
 海康机器人机器视觉工程师认证流程解读(2026年版本)2026-08-20
 【0202016】一站式部署工具MapStudioPro用户手册2026-08-20
 机器视觉项目选型有点烦?做了个AI小助手,免费帮你快速出方案2026-09-03
 浙公网安备 33010802013223号