- 0
- 0
- 分享
- 2026-09-18 10:25
640×480的图,正负180度全角度搜索,缩放范围0.8到1.2——在这个搜索空间里做完一次完整的"找到目标 + 输出亚像素位姿",第一版算法要花一百毫秒上下。
后来我们把它压进了个位数毫秒。
没有用什么黑科技,也没有换更贵的机器。回头看整个过程,真正起作用的其实是四条平平无奇的工程决策。这篇就把它们讲透——不贴公式、不挖实现,讲的是每个做视觉算法的人都用得上的取舍思路。
经验一:先粗后细,把"大海捞针"变成"瓮中捉鳖"
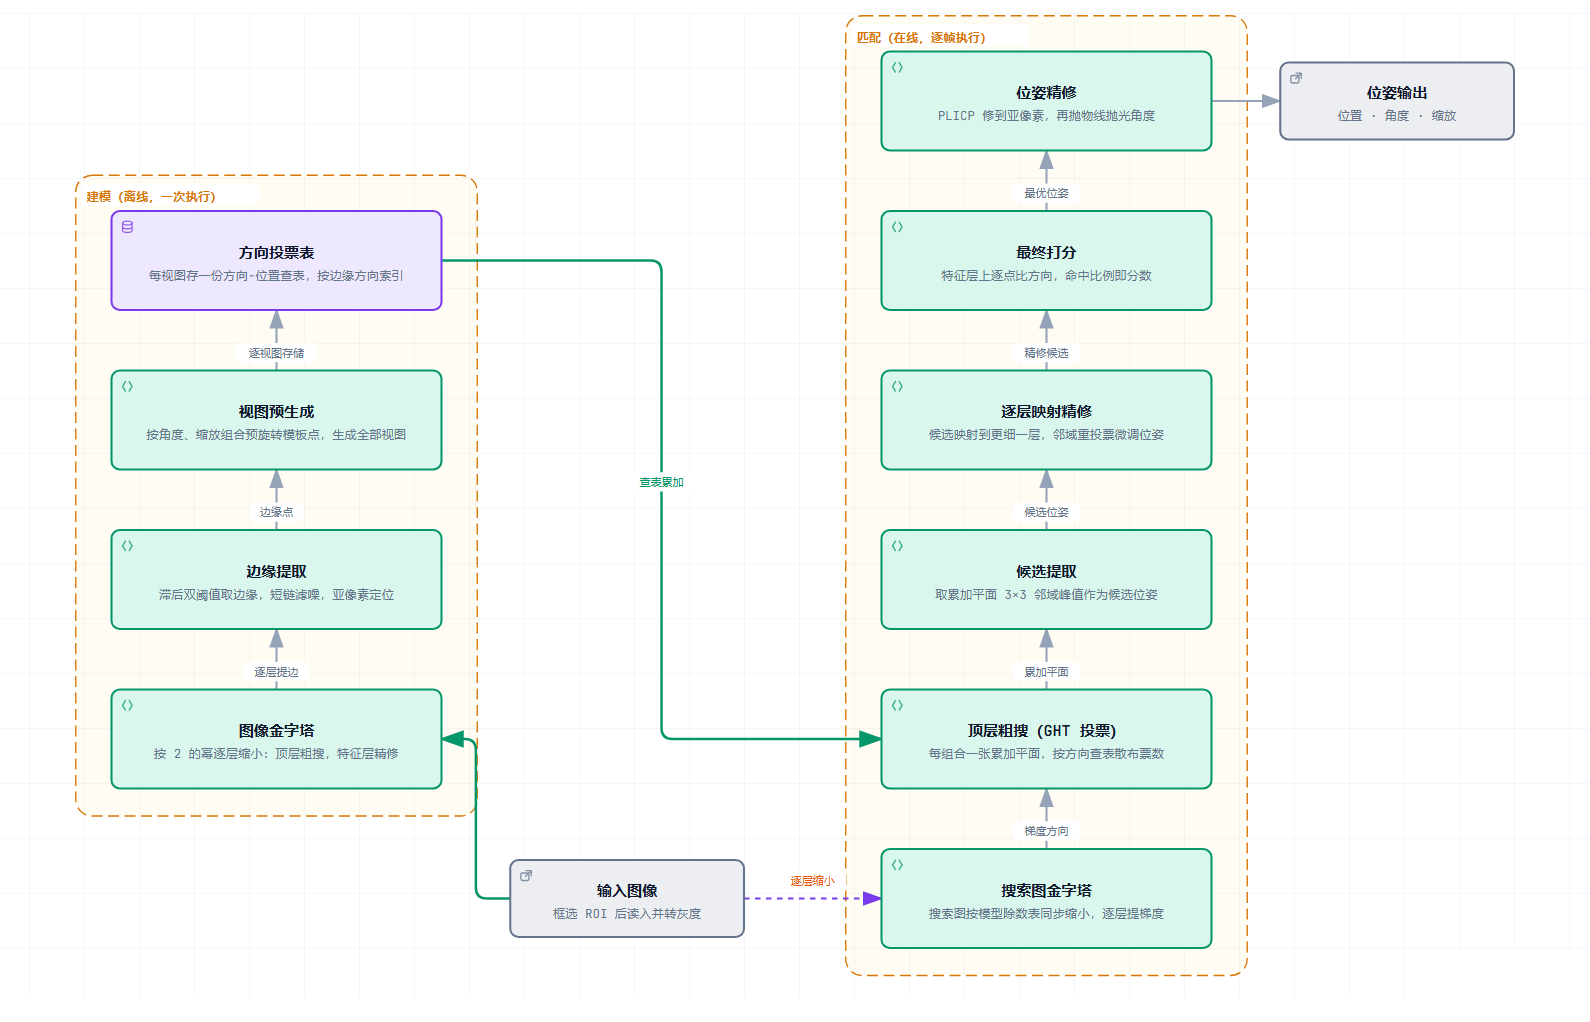
速度的第一功臣是图像金字塔:把原图逐层缩小,在最粗的层上先做全图搜索——小图上每个像素都便宜,扫一遍代价很低;找到少数几个"可能有目标"的候选之后,再把候选坐标映射到更细一层,只在候选附近的小窗口里精细调整。
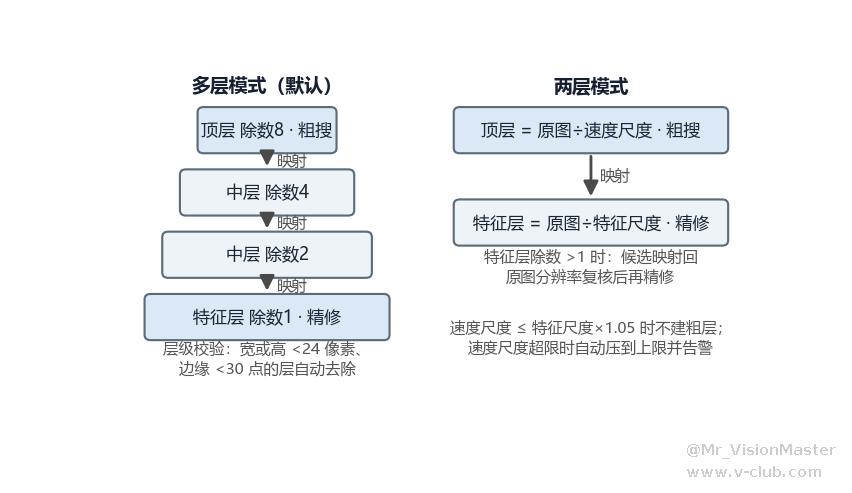
为什么这样能快?因为搜索量被指数级砍掉了:粗层上的一个候选,替代了细层上成千上万次无意义的比对。"大海捞针"和"瓮中捉鳖"的区别,就是百毫秒和毫秒的区别。
这里有个容易忽略的设计点:金字塔不是层数越多越好。层太粗,目标只剩几个像素,特征都没了,粗定位反而不可靠。所以工程上会给粗层设下限——图太小、边缘太少的层,宁可不建。另外还有个变体叫"两层模式":只为高速场景保留"一个粗搜层 + 一个精修层",结构更简单,节拍更极致。
一句话:用分辨率换速度,但要在特征还认得出来的地方换。
经验二:绝大多数计算,本来就不该发生
profiling 之后你会发现一个尴尬的事实:算法里大部分算力,花在那些最后根本不会被采用的候选上。
所以第二条经验是:把"逐个精修"改成"先筛选、再精修、及时止损"。
- 粗定位阶段只保留少数头部候选,而不是把每个峰都当真;
- 每个候选先做一次廉价的预判:如果照目前的走势,分数注定到不了及格线,立刻放弃,后面的重活一件都不干;
- 有些角度和缩放的组合,对当前目标来说"天然无答案",识别出来直接整段跳过。
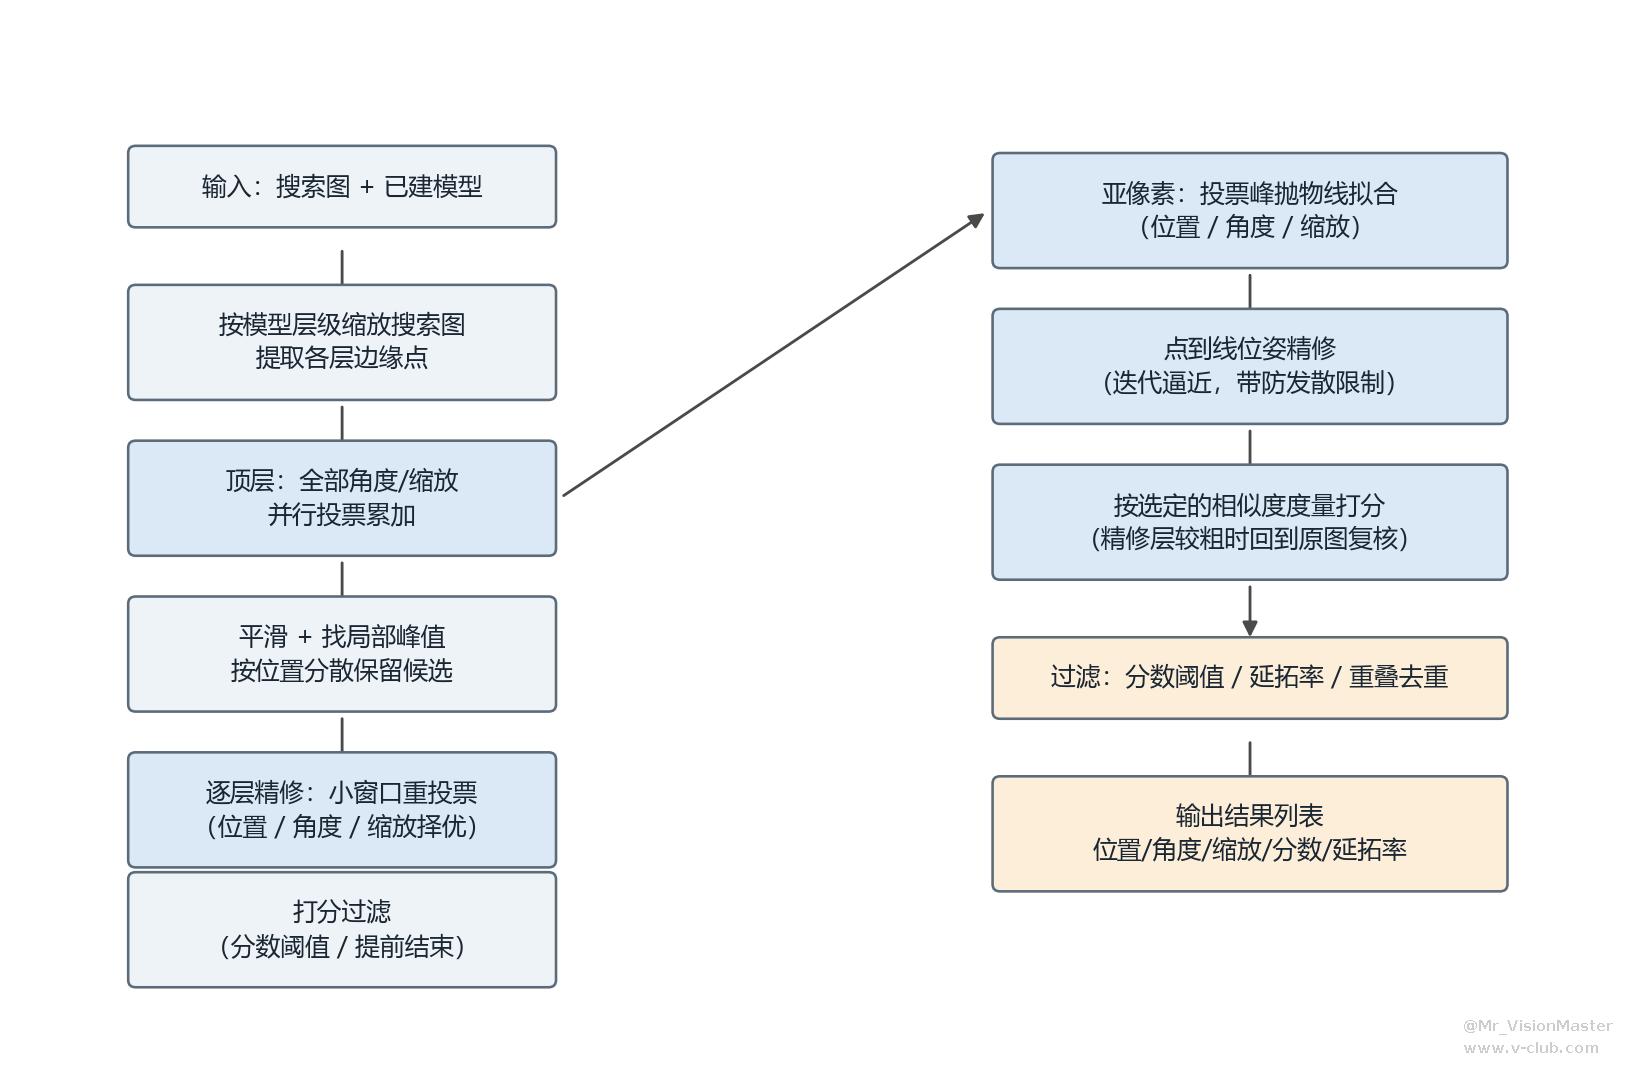
这条经验的通用版本是:在写任何循环之前,先问一句"这个循环里有多少次迭代是白干的"。 把白干的砍掉,比把必要的计算优化到极致,收益大一个量级。
经验三:让数据流"顺"起来,比堆算法更重要
视觉算法是数据密集型的。同样的计算,数据摆放方式不同,速度能差好几倍。三个我们实测有效的方向:
一次计算,处处使用。 同一层的梯度这类中间结果,经常被好几个环节用到——那就只算一次,算完共享,别让每个环节都重算一遍。听起来像废话,但多趟重复计算在老代码里非常常见。
查表代替现算。 很多反复出现的小计算(方向归类、容差判断),事先把所有可能的结果算好存成表,运行时一次查表搞定。表不大,省下来的却是内层循环里的真金白银。
按行组织,顺序访问。 图像处理最爱干的事是从上到下逐行扫。让每个处理环节都按行流水起来、内存顺序访问,缓存命中率自然高。
这三条没有一条是"算法创新",全是教科书级的常识——但毫秒级就是把一条条常识执行到位之后,自然长出来的结果。
经验四:并行要并行在"对的地方"
匹配天然适合并行:多个候选互不依赖、图像按行互不依赖。我们把主要计算按行并行、精修按候选并行,多核机器上收益明显。
但两个坑必须提前知道:
- 并行不是免费的。 线程池有冷启动,任务切分有粒度成本,并行区进出有同步开销。把一个零点几毫秒的小计算强行并行,可能比串行还慢——先测量,再并行。
- 并行区里不能有异常逃逸。 一处没接住的异常穿过并行区,进程直接终止。在工业代码里,并行块内部要自己兜底,把失败变成标志位带出来。
还有一条工业场景特有的要求:确定性。同一张图、同一组参数,今天跑和明天跑必须给出完全相同的结果——平均速度快但结果抖动的算法,在产线上是不可接受的。候选排序里加入固定的次序规则、消除"分数并列时看谁运气好",这类细节不起眼,却是现场敢不敢用你的前提。
避坑清单
- 别急着优化最花时间的函数。 先确认它算的东西是不是都必要——砍掉白干的,比优化必要的见效快;
- 别把参数开到上限。 搜索范围每放宽一档,计算量按比例上涨,工位上用不到的角度范围要主动收窄;
- 别牺牲确定性换平均速度。 现场验收看的是"最差的一次表现",不是"平均表现";
- 别忘了首帧。 用户点下"运行"的第一拍就包含各种冷启动,预热一次再计时,是行业惯例。
最后送一句这几年最深的体会:
算法的快,从来不是靠某一行神奇的代码,而是靠一长串"少做无用功"的决定——每一个决定都很小,加起来就是二十倍。



 在VisionMaster里用自定义算法模块跑YOLOv82026-08-26
 USB工业相机掉线问题排查指南2026-08-26
 海康机器人机器视觉工程师认证流程解读(2026年版本)2026-08-20
 【0202016】一站式部署工具MapStudioPro用户手册2026-08-20
 机器视觉项目选型有点烦?做了个AI小助手,免费帮你快速出方案2026-09-03
 浙公网安备 33010802013223号